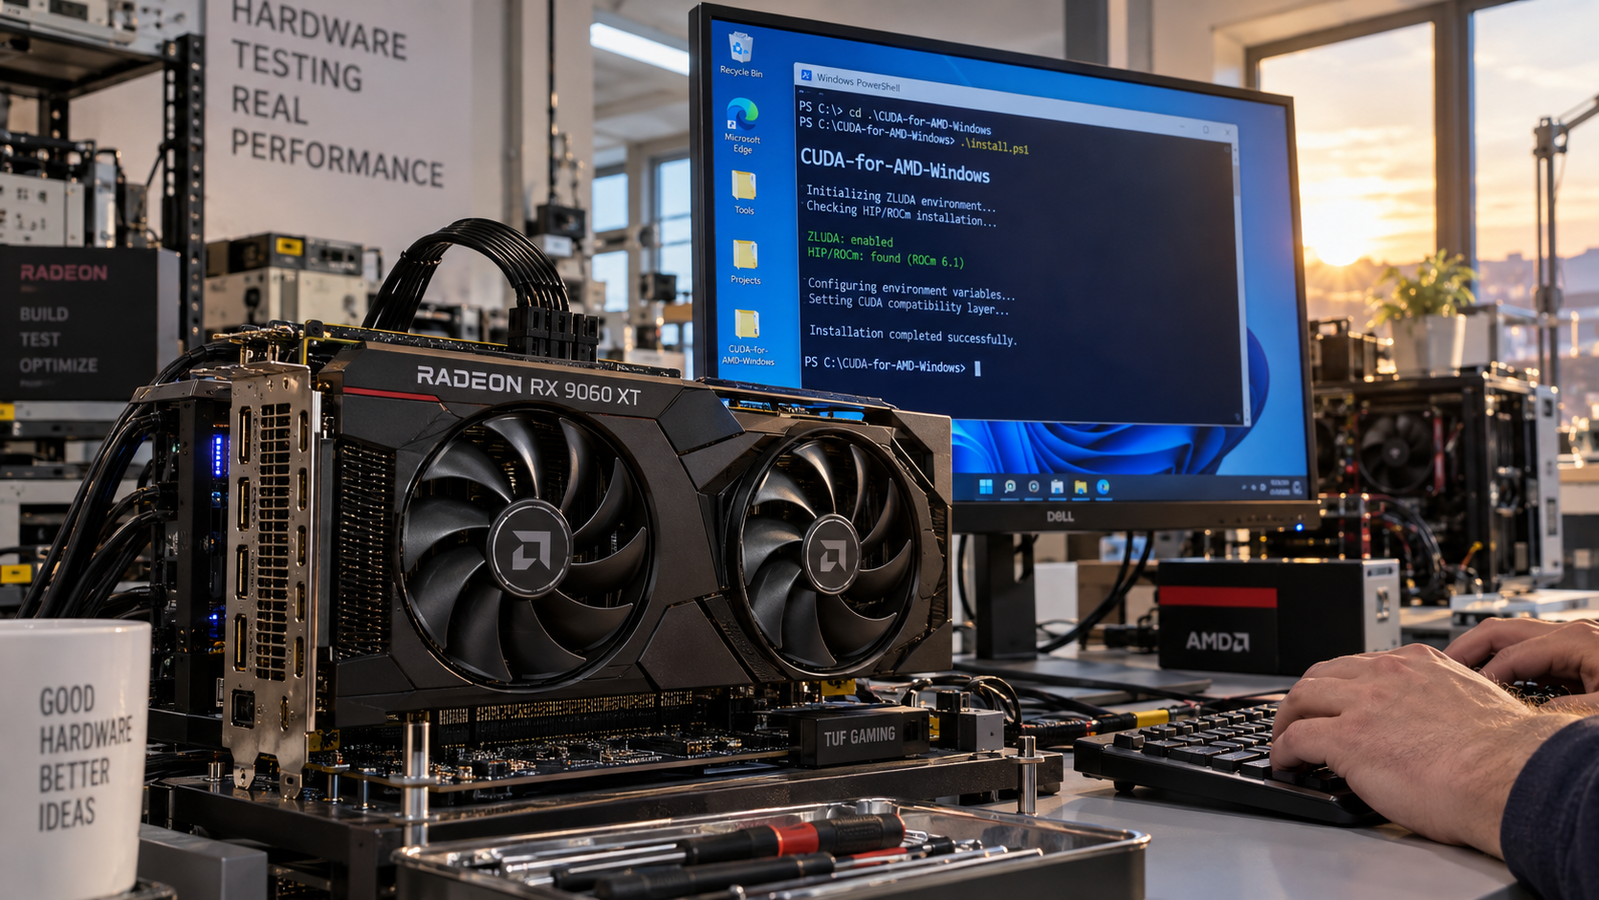
Pare che stia per succedere qualcosa di rivoluzionario nel mondo dell’IA e del computing grafico. Uno sviluppatore indipendente ha sventolato un progetto open source chiamato CUDA-for-AMD-Windows, che fa girare alcune librerie CUDA su una Radeon RX 9060 XT, direttamente in Windows. In pratica, permette di usare carichi di lavoro pensati per l’ecosistema NVIDIA, senza dover passare dalla virtualizzazione o cambiare sistema operativo. Sembra un trucco quasi magico, e lo fa collegando ZLUDA—un ‘traduttore’ per software CUDA—alle librerie di calcolo AMD. Questo ‘ponte’ intercetta le chiamate CUDA e associa servizi fondamentali come quelle per l’algebra lineare (cuBLAS), le matrici sparse (cuSPARSE) e le Trasformate di Fourier (cuFFT) alle rispettive controparti AMD. Il progetto è tutto automatizzato con script PowerShell e, per i nerd, si può persino fissare la versione di ZLUDA per garantire la riproducibilità. L’autore ha voluto dimostrare il novecento, addestrando una rete di 2,2 milioni di parametri con l’algoritmo PPO, utilizzando librerie CUDA non modificate. I test hanno confrontato diverse configurazioni, rivelando che l’approccio standard di ZLUDA e l’SDK HIP di AMD ha raggiunto una velocità impressionante di 13.278 passi al secondo. Sebbene ci siano delle limitazioni (non copre cuDNN, TensorRT e NCCL, né funziona su altre schede), questo sforzo è un colpo grosso per la democratizzazione del computing, dimostrando che il codice può parlare un linguaggio comune, almeno per i carichi di lavoro che non fanno i capricci!
🇬🇧 Summary in English
Looks like the AI compute world is getting a serious shake-up. An independent developer just unleashed an open-source project called CUDA-for-AMD-Windows, which lets several CUDA libraries run on a Radeon RX 9060 XT, straight up in Windows. This is the holy grail for many developers: it means running workloads designed for NVIDIA’s ecosystem without needing complex virtualization or switching operating systems. The trick? It cleverly links ZLUDA—a kind of translation layer for CUDA software—to AMD’s native compute libraries. This ‘bridge’ intercepts crucial CUDA calls and maps fundamental functionalities, like those for linear algebra (cuBLAS), sparse matrices (cuSPARSE), and Fourier Transforms (cuFFT), to their AMD equivalents. The whole setup is reproducible using PowerShell scripts. To prove it works, the developer trained a 2.2 million-parameter network using the PPO algorithm. The tests compared different setups, finding that the standard ZLUDA and AMD HIP SDK approach reached a solid median speed of 13,278 steps per second. While there are still kinks to iron out—it doesn’t handle cuDNN, TensorRT, or NCCL, and is limited to the RX 9060 XT—this project is a massive step toward democratizing compute power. It proves that the code can learn to speak a common language, making high-performance AI accessible to a wider array of hardware! Keep your eyes on this one; it’s huge for the open-source crowd.
Leggi l’articolo originale su Tom’s Hardware IT →
Fonte: Tom’s Hardware IT | Argomento: Tech News
#tecnologia #innovazione #technews