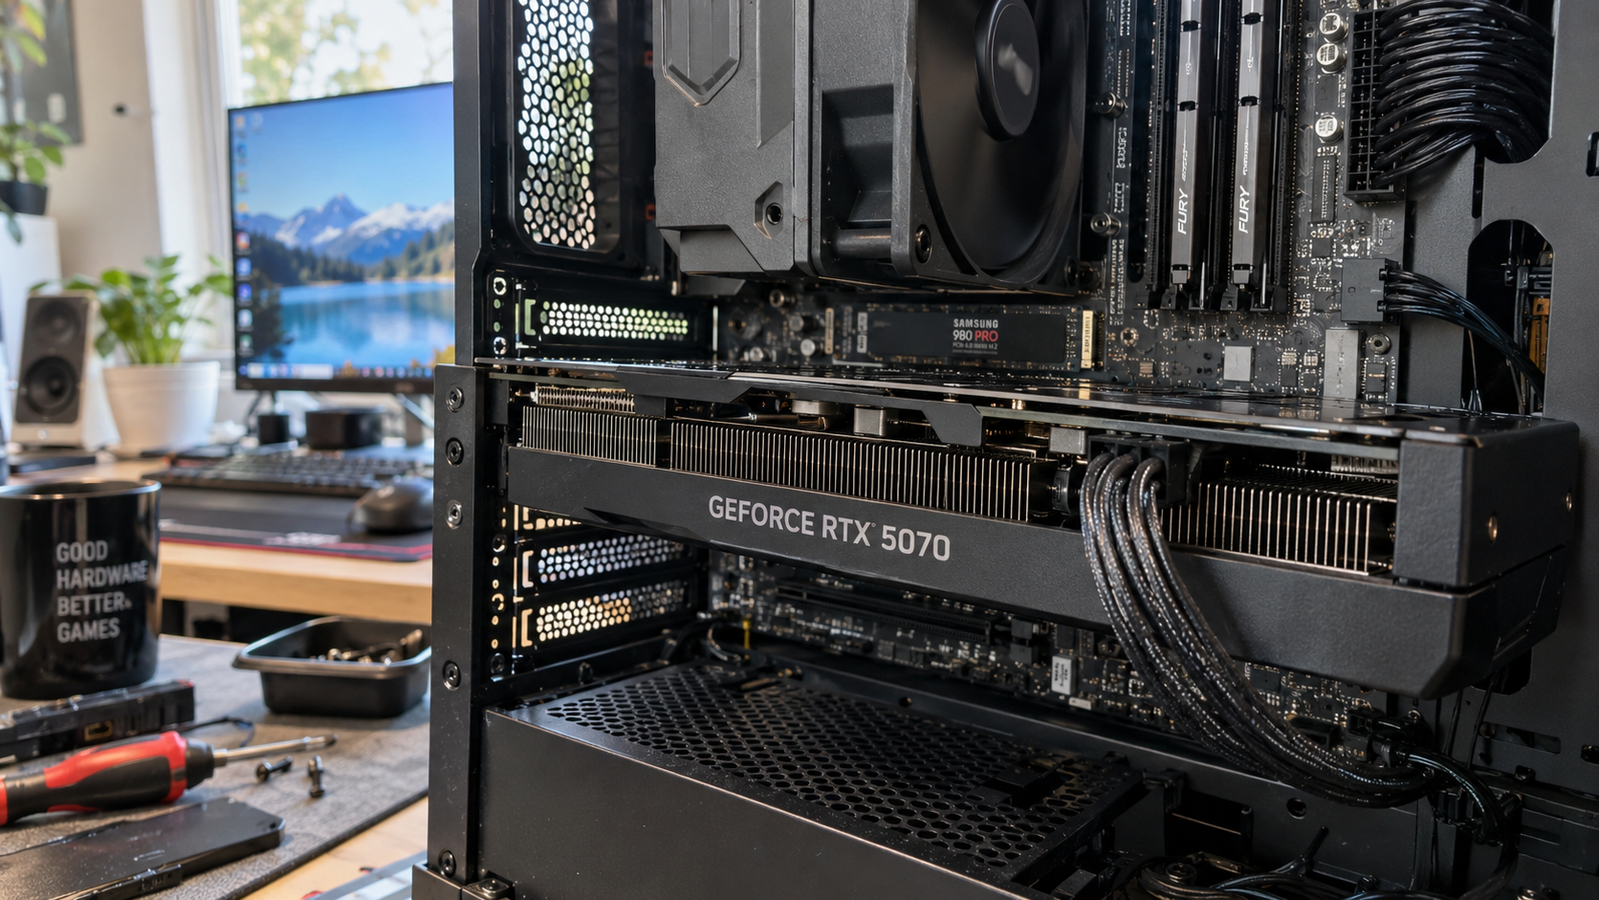
Il progetto Strata , sviluppato da Niko1221, permette di eseguire localmente un modello linguistico da 125 miliardi di parametri su un PC con una RTX 5070 da 12 GB. Il software distribuisce i dati tra memoria della scheda video, RAM di sistema e SSD, portando un modello di queste dimensioni su una configurazione accessibile anche a chi possiede già un computer da gaming. Alla base c’è Qwen3.8-Flash-Next , un modello con architettura mixture-of-experts : contiene 24.576 piccoli esperti, ma ne impiega soltanto dieci per ciascun token elaborato. Questa selezione permette al software di lavorare su una frazione degli esperti a ogni passaggio, invece di dover utilizzare contemporaneamente l’intera raccolta. È su questa caratteristica che Strata costruisce la propria gestione della memoria. La VRAM come cache è il meccanismo centrale: gli esperti utilizzati più frequentemente restano sulla GPU, mentre la raccolta completa risiede normalmente nella RAM del computer. Il modello comprende inoltre una tabella di consultazione da circa 29 GB, conservata sull’SSD e letta quando serve. La capacità della memoria video, quindi, non deve corrispondere alle dimensioni dell’intero modello: i diversi livelli di memoria si dividono il carico. Usare la memoria video come cache permette a Strata di eseguire un modello da 125 miliardi di parametri distribuendone i dati tra GPU, RAM e SSD. Strata sfrutta anche la previsione di più token del modello per il decoding speculativo , verificando diversi t
🇬🇧 Summary in English
Il progetto Strata , sviluppato da Niko1221, permette di eseguire localmente un modello linguistico da 125 miliardi di parametri su un PC con una RTX 5070 da 12 GB. Il software distribuisce i dati tra memoria della scheda video, RAM di sistema e SSD, portando un modello di queste dimensioni su una configurazione accessibile anche a chi possiede già un computer da gaming. Alla base c’è Qwen3.8-Flash-Next , un modello con architettura mixture-of-experts : contiene 24.576 piccoli esperti, ma ne impiega soltanto dieci per ciascun token elaborato. Questa selezione permette al software di lavorare su una frazione degli esperti a ogni passaggio, invece di dover utilizzare contemporaneamente l’intera raccolta. È su questa caratteristica che Strata costruisce la propria gestione della memoria. La VRAM come cache è il meccanismo centrale: gli esperti utilizzati più frequentemente restano sulla GPU, mentre la raccolta completa risiede normalmente nella RAM del computer. Il modello comprende inoltre una tabella di consultazione da circa 29 GB, conservata sull’SSD e letta quando serve. La capacità della memoria video, quindi, non deve corrispondere alle dimensioni dell’intero modello: i diversi livelli di memoria si dividono il carico. Usare la memoria video come cache permette a Strata di eseguire un modello da 125 miliardi di parametri distribuendone i dati tra GPU, RAM e SSD. Strata sfrutta anche la previsione di più token del modello per il decoding speculativo , verificando diversi t
Leggi l’articolo originale su Tom’s Hardware IT →
Fonte: Tom’s Hardware IT | Argomento: Tech News
#tecnologia #innovazione #technews